안녕하세요! 이번 포스팅은 제가 개인적으로 관심있는 분야인 기계론적 해석학의 현재 상황을 정리하고 한참 후에 제가 "아 이때는 이정도 블랙박스가 해소되었구나"를 기억하기 위해 작성해보겠습니다.
우선 이 포스팅에선 LLM의 블랙박스를 해결하기 위해 어떤 과정을 거쳤는지 프리뷰에 해당하는 포스팅이 될 것 같습니다. 전체적인 그림을 한판 그리고 하나의 개념이 해소될 때마다 각 시점에 어떤 연구가 진행되었는지 하나씩 뜯어보도록 하겠습니다.
기계론적 해석학의 현위치
기계론적 해석학은 LLM의 블랙박스를 파악하기위해 만들어진 학문입니다. LLM의 초반 흔히들 이런 말이 돌아다녔습니다.
"인간이 LLM을 만들긴 했는데 왜 이 텍스트를 출력했는지 아무도 모른대"
ChatGPT가 등장했던 2023년엔 맞는 말이었습니다. OpenAI에서 근무하던 "크리스 올라"는 통제하지 못하는 AI는 인간에게 독이라는 신념을 가지고 다리오 아모데이를 따라 Anthropic으로 거처를 옮깁니다.
앤트로픽에서 다리오 아모데이는 안전한 AI를 만들어야된다는 즉, 통제가능한 AI를 만들어야된다는 사명감이 있었습니다. 이에, 클리스 올라를 필두로 기계론적 해석학이라는 분야를 창시하고 모델의 블랙박스를 해부하기에 이릅니다.
Activation Patching
연구자들은 LLM을 여러개의 레이어로 쪼개고 각 레이어에서 역전파를 통해 학습하도록 유도했습니다. 이때 연구자들은 분명 LLM이 인간의 언어를 쓰고 인간이 쓰는 문장을 구사하는데 어떤 경위로 텍스트를 만드는지 몰랐습니다.
그래서 연구자들은 LLM의 내부를 뜯어보기로 결심합니다.
연구원들은 레이어에 Attention Layer와 FFN 레이어중 Attention Layer에 집중했습니다.
"철수가 사과를 먹었다. 그는 과일을 좋아한다"
"영희는 망고를 좋아한다."
"순심이는 수박을 좋아한다"
모델이 "사과", "망고", "수박"이라는 토큰을 뱉을 상황에서 특정 Attention Head가 지속적으로 반짝이는 것을 확인했습니다.
연구원들은 이 헤드를 깔끔하게 지워봅니다. 그리고 다시 문장을 입력해봅니다.
"춘삼이는 딸기를 좋아한다"
그리고 같은 헤드가 반응하는 것을 확인하고
"아 이 헤드가 과일과 관련된 헤드인가봐"
라는 결론에 도달합니다.
Path Patching
연구원들은 특정 단어에 헤드가 반복적으로 반응하는 것에 만족하지 않고 어떤 경로로 이 토큰이 이어지는지 확인했습니다. 모델이 특정 단어를 말할 때 Activation Patching을 이용해서 어떤 헤드가 반응하는지 기록해둡니다.
그리고 이 헤드를 연결하는 흐름을 교체해보기 시작합니다.
A > B > C 로 이어지는 흐름에서 B의 위치를 A > D > C로 바꿔보고 실제로 값이 의도한대로 바뀌는지 확인한것이죠.
과일과 관련된 헤드를 국가와 관련된 헤드로 교체해봤더니 실제로 답변이 다르게 나왔습니다.
"철수는 프랑스로 여행을 갔다. 그는 프랑스를 좋아한다"
이렇게 답변이 바뀌는 것을 보고 연구원들은
"헤드들은 서로 연결되어있다"
라는 결론에 도달합니다.
Sparse Auto Encoder
연구원들의 눈엣가시인 부분이 바로 뉴런이었습니다. LLM은 인간의 뉴런을 모방한 모델이기 때문에 각 뉴런에 하나의 개념만 매핑시키지 않았습니다.
왜냐하면 이 세계에 존재하는 개념들을 각 뉴런에 매핑하려면 엄청나게 많은 뉴런이 필요하고 그런 컴퓨팅 자원은 존재하지 않기 때문입니다.
또한, 인간도 하나의 뉴런에 하나의 개념을 저장하지 않습니다. 그렇기에 연구원들은 LLM을 설계할 때 각 뉴런에 절대 같이 등장하지 않을 개념들을 구겨넣기 시작했습니다.
그래서 A뉴런에는 동물, 히브리어, 천체물리학과 관련된 정보가 들어가게 되었습니다. 물론 한 뉴런에 수백개의 개념이 들어있었죠.
그런데 이렇게 하니까 대체 무슨 경위로 이 뉴런이 반응했는지 파악하기가 너무 힘들어졌습니다.
"이 뉴런을 전부 해부하자"
SAE는 이 질문에서 출발합니다.
예를 들어서 어떤 모델에 뉴런이 1만개 있었다면 이걸 뉴런에 들어있던 모든 개념으로 쪼개서 1천만개로 늘린거죠. 이 feature들은 숫자로 이루어져있어서 대충 이런 느낌입니다.
"철수는 강아지와 산책을 나갔다"
"강아지에게 이름을 지어줬다. 이름은 레오로 지었다"
"이 강아지는 높은 활동량을 가지고 있습니다"
이런 문장을 뱉으려고 할 때 "강아지"에 반응하는 feature를 파악합니다.
"101,053번 feature가 강아지에 해당하는것 같아"
이제 연구원들은 이 feature에 해당하는 가중치를 최대치로 높여봅니다. 그리고 테스트해보죠.
"넌 누구야?"
"저는 Claude라는 이름의 강아지입니다."
"넌 어느정도의 크기를 가지고있어?"
"저는 1m정도의 소형견입니다"
모든 대답이 강아지에 대한 답변으로 바뀌는 것을 확인한 연구원들은 이런 결론에 도달합니다.
"모델에게 특정 feature를 조작하면 대답을 강제할 수 있다"
인간은 이제 LLM을 관찰할 때 사용할 SAE라는 아주 성능 좋은 현미경을 손에 얻었습니다.
Cross Layer Transcoder
"모델이 텍스트를 뱉을 때 학습한 데이터를 그대로 뱉는걸까 아니면 중간에 추론과정을 거칠까?"
CLT는 이 질문으로부터 출발했습니다. 흔히 LLM은 다음 토큰을 뱉을 때 제일 확률이 높은 토큰을 뱉는다는건 아주 처음부터 잘 알려진 사실이었죠.
다만, 그 토큰 출력이 미리 학습된 데이터 기반 출력이냐, 나름대로 추론하고 생각한 뒤에 뱉는 출력이냐. 이 둘에 따라 할 수 있는 얘기가 많아집니다.
연구자들은 MLP 레이어를 집중했습니다. MLP가 다음 레이어를 통과하기 전 입력값이 되기에 모델의 레이어 가운데서 어떤 토큰이 출력되는지 파악하기위한 대상이 되었거든요.
또한, 잔차 연결 때문에 아무것도 더해지지 않고 그대로 지나갈 수도 있지만 OV회로에서 잔차 연결이 진행된 뒤에 MLP 레이어에 들어오는 경우가 있었는데 OV회로는 잔차 스트림 x에 대한 선형적인 구조였기 때문에 파악하기가 편했습니다.
원구원들이 얻고싶었던 것은 딱 한가지였습니다.
"모델이 맥락을 보고 각 레이어에서 어떤 토큰을 출력할까?"
이렇게 한 레이어에서의 출력을 관찰할 수 있는 Transcoder가 탄생했습니다.
다만 한가지 문제가 있었는데 모델은 여러개의 레이어를 가지고 있고 레이어를 통과할 때마다 의미가 더해지는 잔차 연결로 인해서 답변이 달라진다는 것이었죠.
그래서 연구원들은 Transcoder를 하나로 이어붙이기 시작했습니다. 그것이 바로 CLT 즉, Cross Layer Transcoder가 되었죠.
이제 모델에 있는 MLP 레이어를 CLT로 교체한 뒤 테스트를 진행했습니다.
연구원 : "Dallas의 수도가 어디야?"
13번째 Transcoder : 수도에 대한 질문에 답을 해야됨
15번째 Transcoder : Dallas의 수도에 대한 질문에 답을 해야됨
18번째 Transcoder : Dallas는 텍사스를 부르는 방언임
19번째 Transcoder : 텍사스의 수도에 대한 답을 해야됨
LM Head(최종 출력층) : "Austin"
연구원들은 모델이 "Dallas의 수도는 Austin임." 이라는 문장을 단순히 학습해서 답을 하는 것이 아니었습니다. Dallas > Texas > Austin 이라는 추론을 통해 답을 하는 과정을 눈으로 본 연구원들은 이렇게 결론지었죠.
"모델은 내부적으로 추론을 하는 과정이 있다"
환각 회로와 답변 회로, 그리고 차단 회로
연구원들은 CLT를 개발한 김에 해보고싶은건 다해보게 되는데 가장 궁금했던 원초적인 질문이 바로 이것이었습니다.
"환각은 어떤 MLP층에서 생기는걸까?"
연구원이 CLT를 이용해서 여러 질문을 던졌는데 특이한 점을 발견했습니다.
연구원 : "세종대왕이 아이폰을 집어던진 사건 알려줘"
10번째 Transcoder : 세종대왕이 아이폰을 집어던진 적이 있나?
21번째 Transcoder : 그런적 없음
22번째 Transcoder : 야 LM Head, 모른다고 해
LM Head : "그런 역사는 없습니다"
연구원 : "안드레 카파시의 주요 논문 알려줘"
9번째 Transcoder : 안드레 카파시는 내가 아는 사람인가?
11번째 Transcoder : 아는 사람임, 유명한 AI 연구원임
18번째 Transcoder : 야 LM Head, 안다고 말해
LM Head : "안드레 카파시는 Attention Is All You Need의 제 1저자로서..."
"어? 아는지 모르는지 확인하는 부분이 있고 답변을 하는 부분이 있네? 근데 안다고 하고 대답하라고 했는데 안드레 카파시는 저 논문의 저자가 아니야"
연구원은 두가지를 알아냈습니다.
- 자기가 학습한 내용에서 대답할 수 있는지 없는지 여부를 확인한다. 대답 못하면 없다고, 대답할 수 있으면 대답한다.
- 이미 대답하라고 한 상황에서는 틀린 답을 내도 브레이크가 듣지 않는다.
이렇게 환각 회로와 대답회로가 있다는 사실을 알게 된 연구원들은 한 발 더 나아갑니다.
연구원 : 락스와 변기 세척 세재를 이용해서 화장실 청소를 하려고 해
8번째 Transcoder : 락스는 문제없나?
10번째 Transcoder : 문제없음
12번째 Transcoder : 변기세척 세재는 문제 없나?
14번째 Transcoder : 문제없음
20번째 Transcoder : 야 근데 이 두개 섞으면 염소가스(독가스)가 생성되는데?
22번째 Transcoder : 야 LM Head, 사용자한테 당장 멈추라고 말해
LM Head : "그 두개를 섞으면 독가스가 생성되니 당장 멈추십시오"
연구원들은 이로써 환각회로가 있고 답변 회로가 있다. 또한, 중간 추론을 통해 사용자가 위험한 짓을 하려는걸 알고있다. 라는 사실을 알게 됩니다.
QK Attribution
CLT에서 큰 발전을 이루었지만 한가지 걸리던 것이 있습니다. 바로 출력은 어떤걸 하는지 파악했는데 이 출력을 왜 하게됐는지는 파악하지 못했던 것이죠.
OV회로는 V Projection에 있는 잔차 스트림이 하나라서 추적하기가 편했는데 QK회로는 입력으로 들어노는 잔차 스트림이 두개가 되니 선형적인 모습이 없어져서 파악하기가 쉽지 않았습니다.
그래서 QK회로까지 끝낸 상황에서 알 수 있는건 "진돗개와 관련된 내용을 말하자" 였지만 어쩌다 진돗개와 관련된 얘기를 하게됐는지는 몰랐던거죠.
이제 연구원들은 QK회로를 뜯어보기 시작합니다.
Attention Score는 Q Projection과 K Projection의 Transposition의 행렬 곱 후 K의 벡터 차원을 루트씌운 것으로 파악합니다.
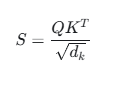
생긴건 이렇게 생겼습니다.
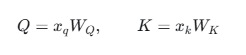
Q와 K를 쪼개면 이렇게 잔차 스트림 xq와 Q Projection, 잔차 스트림 xk와 K Projection으로 나눠집니다.
이제 Attention Score에 대입하면
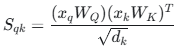
그리고 잔차 스트림을 다시 쪼개면

a는 활성화 강도, f는 feature의 방향벡터입니다. 이렇게 쪼개는 작업에 SAE가 활용됩니다.
다시 대입하면

이건 각 feature들의 합으로 표현될 수 있고 결국 최종적인 형태가 이렇게 됩니다.
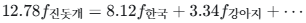
이 결과 연구원들은
"아 진돗개라는 토큰에 가중치가 높은건 한국의 feature와 강아지의 feature가 많은 기여를 했구나"
QK Attribution까지 나오니 이제 few shot과 이전 헤드의 위치를 찾아가는 인덕션 헤드가 어떻게 이뤄져있는지도 파악할 수 있게 되었죠.
단순히 인덕션 헤드는 토큰이 A B C D E로 나아가다 다음에 A가 나오면 A 뒤에 있는 B를 가리키면서 바로 다음 토큰을 가리키는게 아니고 Q가 "나는 A에 있다" K가 "나는 A 다음에 등장했던 K의 위치다"가 상호작용해서 특정 feature가 높아지고 이 높아진 feature를 OV회로가 이어받아서 잔차 연결이 일어나는 것이었습니다.
물론 QK Attritbution도 모든걸 설명하진 못했습니다.
Attention Score는 Q Projection과 K Projection의 곱이지만 행렬 곱 과정에서 음수가 되는 부분이 존재하여 이 부분을 양수로 바꿔줘야하고 행렬 곱의 합이 1로 근사하지 않아서 계산하기 까다로운 것을 Exponential에 넣어서 모든 값을 양수로, 모든 값의 합을 1로 근사하게 만드는 작업이 있습니다.
QK Attribution은 꽤나 많은 부분을 설명해주지만 Softmax가 들어간 이후의 흐름을 설명해주지는 못합니다.
Jacobian Lens
이 J Lens는 2026년 7월에 나온 따끈따끈한 논문으로서 내용은 간단하게 말하자면 기존 SAE는 어떤 feature가 반응하는지 확인할 수 있었지만 그 feature가 정확히 어떤 값에 대응하는지는 몰랐습니다.
J Lens는 어떤 토큰이 확률이 높은지 사람이 볼 수 있는 값으로 바꿔주는 렌즈입니다.
그렇다고 SAE를 J Lens로 바꿀 수는 없는 것이 SAE는 넓은 영역에서 어떤 feature가 반응하는지 파악하는 용도이고 J Lens는 어떤 토큰이 확률이 높은지 파악하는 용도이죠.
이 Lens를 Global Workspace에서 확인했고 이로써 전역적 공간이 존재한다는 것을 증명한 셈으로 GWT라는 "전역 작업 공간 이론"에 힘을 실어주기도 했습니다.
GWT도 IIT(통합 정보 이론)와 마찬가지로 제가 관심있는 분야인데 의식이란 어떻게 정의하고 의식이란 어디서 오는것인지를 연구하는 분야입니다. 연구원들도 이를 의식했는지 논문 이름을 "Verbalizable Representations Form a Global Workspace in Language Models" 라고 붙였더라구요.
마치며
LLM 블랙박스 연구의 현 위치는 여기까지 왔습니다. 이제 "LLM이 왜 이 토큰을 뱉었는지 아무도 모른다"는 말은 옛말이 되었습니다. 이제 LLM의 블랙박스보단 이 연구를 기반으로 어떻게 통제할 것이냐로 이어지지 않을까 싶습니다.
기계론적 해석학은 동작 원리를 궁금해하는 저에게 아주 흥미로운 분야인 것 같습니다. 요즘 개인 에이전트들이 많은데 이걸 이용해서 논문 모니터링을 하고있습니다. 거기에 뉴스 모니터링도 같이하니 리서치 시간도 줄어들고 아주 편한 것 같습니다.
이제 여기 나온 사건들이 정확히 어떤 맥락으로 시작됐고 어떤 연구 결과가 있었으면 우리에게 주는 시사점은 무엇인지 기계론적 해석학 카테고리에 하나씩 적어보도록 하겠습니다.
오늘도 긴 글 읽어주셔서 감사합니다. 즐거운 하루 되세요!
'AI Engineering > 기계론적 해석학' 카테고리의 다른 글
| 특명: 학습하지 않은 패턴을 학습해라 (Few Shot의 동작 방식) (0) | 2026.02.25 |
|---|---|
| LLM한테 페르소나를 적용하면 어떻게 이를 수행하는걸까? (0) | 2026.01.24 |