안녕하세요! 이전 포스팅에서는 Attention Layer에 대해서 짚어보면서 어떻게 모델이 맥락을 만들어내는지 알아봤습니다. 이번 포스팅에서는 Attention Layer가 던져준 맥락을 잘 토스해서 출력까지 스무스하게 이어주는 MLP(구 FFN)에 대해서 정리해봤습니다!
MLP는 2017년 Transformer 알고리즘의 초기부터 존재했던 근본 개념입니다. 이전 포스팅에서 Transformer라는 회사에 자료조사 팀인 Attention 부서와 분석팀 MLP가 있다고 예시를 들었습니다.
MLP는 자료조사가 끝난 뒤 토큰의 분석을 맡고 있고 잔차 연결로 이어지는 이 흐름을 조금 더 구체적으로 풀어보도록 하겠습니다.
본격적으로 포스팅 시작하겠습니다!
MLP의 역할
MLP는 Multi-Layer Perceptron의 약자로 과거 Transformer 원 논문에서는 Feed-Forward Network, 이를 줄여 FFN이라고 부르곤 했습니다.
Attention과 MLP의 가장 큰 차이는 Attention은 여러 토큰과의 상호작용으로 맥락을 찾아내는 과정이고 MLP는 독립적으로 작동한다는 점입니다.
MLP가 직접 옆 토큰이나 앞 토큰을 찾아가지는 않습니다. 단지 Attention이 모아둔 맥락과 현재 위치에서의 정보를 바탕으로 가장 알맞은 표현을 반환할 뿐입니다.
우리가 MLP가 되었다고 가정해보고 독립적으로 움직인다고 가정해보죠. 앞에서 Attention이 다음과 같은 맥락을 주입했습니다. 우리는 토큰과 상호작용을 하지 않기 때문에 질문이 무엇인지도 모릅니다.
Attention Layer
1번 헤드 : 현재는 질문에 대한 답을 해야하는 위치입니다.
2번 헤드 : 앞에서 프랑스가 언급되었습니다.
3번 헤드 : 질문의 대상은 수도입니다.
"지금 질문이 프랑스 수도를 물어보는군 그럼 다음 토큰은 파리다!"
이처럼 토큰과 상호작용하지 않아도 현재 위치의 토큰이 파리와 연관성이 높다는 결론은 내릴 수 있습니다.
물론 MLP는 모델의 각 레이어에 하나씩 들어있기 때문에 정확히 이런 사고를 거친다고 단정지을 수는 없지만 중요한 것은 MLP는 Attention이 가져온 맥락을 통해 잔차 연결을 이뤄낸다는 것이죠.
잔차 연결에 대한 내용은 이전 포스팅에서 언급됩니다!
https://coding-review.tistory.com/627
기획자에겐 그림판을, 개발자에겐 메모장을 쥐어줬다 (MHA, MQA, GQA)
안녕하세요! 조금 자극적인 제목으로 인사드립니다. 저번 포스팅에선 Attention 레이어, 그 중에서도 Q, K, V의 연산 과정 하나에 관한 내용을 포스팅했습니다. 그래서 이전 포스팅을 통해 Q, K, V가
coding-review.tistory.com
정리하자면 그럼 Attention Layer에서 QK회로는 맥락을, OV회로는 잔차연결을 이뤄냈고 그 맥락을 MLP가 이어받아서 다시 잔차연결을 이뤄내는 그림이 그려지게 됩니다.
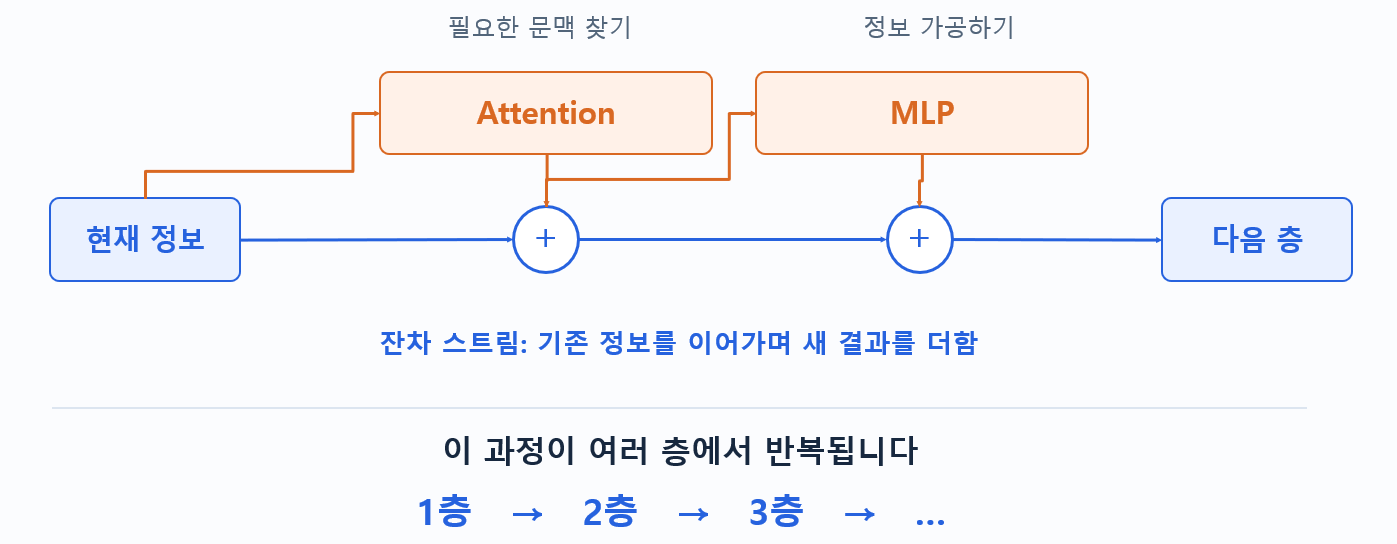
MLP와 SwiGLU
MLP가 Attention에게 받은 맥락을 해석하는 과정도 재밌는데요.
과거 Transformer 원 논문에서는 ReLU라는 개념이 있었습니다. 흔히 이걸 "활성화 함수"라고 부르는데요. 어떤 특징에 더 가중치를 두어 토큰을 활성화시킬까를 고민한 계층입니다.
ReLU의 방식은 단순하게 "이 특징을 얼마나 활성화시킬까?" 만을 고민했습니다. 하지만 시대를 거치면서 MLP에 SwiGLU라는 개념이 추가됩니다.
SwiGLU(스위-글루)란?
QK회로에서 맥락을 가져올 때 고차원의 벡터가 만들어지는데 이 벡터는 보통 수백차원에 이르는 거대한 차원이지만, 어떤 특징을 얼마나 활성화시킬지를 고민하기엔 굉장히 작은 차원입니다.
사과와 배, 이 두 토큰이 있다고 가정해봅시다.
각 차원(속성)을 들여다보면 사실 이 둘은 큰 차이가 없을지도 모릅니다. 둘 다 과일이라는 속성을 가지고 있고 크기도 비슷하고 달다라는 속성도 같이 존재하죠. 그리고 가운데 씨가 비슷하게 들어있고 나무에서 자란다는 공통점이 굉장히 많습니다.
하지만 이건 큰 틀에서 본거고 사실 짚고들어가면 사과와 배는 아주아주 다르죠. SwiGLU는 이런 개념과 굉장히 흡사합니다.
기존 ReLU는 두 토큰간 속성이 너무 가까이 있는 것 처럼 보여서 어떤걸 활성화시킬지 애매했다면 SwiGLU는 차원 자체를 넓혀버려서 토큰 간 속성이 더욱 눈에 잘 띄게 만들어줍니다.
엄청나게 가까이 붙어있는 줄 알았던 두 속성이 현미경으로 들여다보니 사실은 굉장히 멀리 떨어진 것과 같은 맥락입니다.
(사진)
MLP의 마법 MoE
SwiGLU까지 도입한 연구자들은 DeepSeek의 MoE라는 패턴에 집중하게 되었습니다. 그래픽카드가 부족한 중국은 Attention Head가 여러개 만들어졌을 때 발생하는 막대한 양의 KV 때문에 KV Cache를 담을 VRAM이 부족해지고 마개조를 시작해야했습니다.
중국 연구자들의 시작은 다음과 같습니다.
"모든 MLP를 쓸 필요가 있을까?"
MLP를 필요한 애만 활성화시켜서 토큰을 출력하게 하면 KV Cache를 압도적으로 줄일 수 있지 않을까? 이 질문은 MoE라는 희대의 아키텍처를 만들어냅니다.
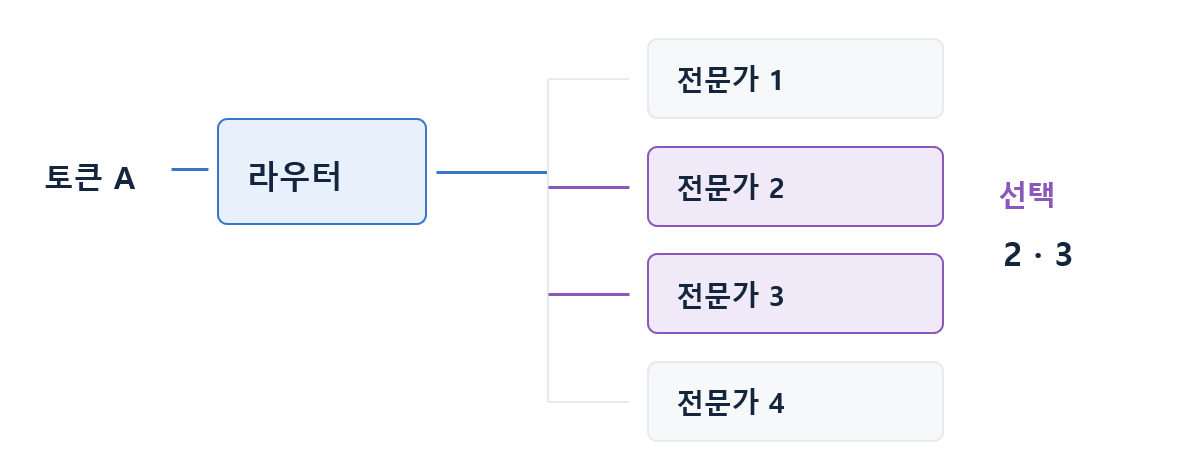
앞에 이 질문이 어떤 MLP를 활성화시킬지 게이트웨이가 있고 이 게이트웨이를 통과하고나면 어떤 MLP가 활성화될지 결정됩니다. 그럼 그 과정에서 여러겹에 있던 MLP중에 일부만 활성화되고 실질적으로 모델의 크기가 작아지는 효과를 볼 수 있었죠.
Macaron 모델과 Hybrid 모델
MoE는 많이들 들어보셨어도 이건 많이 못들어보셨을텐데요. 이 두 모델도 MLP를 마개조한 모델입니다.
Macaron 모델
네 그 마카롱 맞습니다. 보통의 LLM은 Attention - MLP 의 구조로 되어있는 것을 MLP - Attention - MLP 이렇게 두개로 쪼갠 것입니다. 그래서 마카롱이죠.
이렇게 쪼개서 얻을 수 있는 이점은 근거리에 있는 앞뒤 맥락을 더 쉽게 파악할 수 있다는 것인데요. 그렇기에 이 모델은 음성모델에 주로 사용됩니다.
음성은 국소적으로 짧은 거리에 있는 토큰들의 맥락이 굉장히 중요해서 뒤에 뭐가 오느냐에 따라 맥락이 180도 달라질 수 있는 음성 전용 모델에 주로 사용됩니다.
Hybrid 모델
Hybrid 모델도 어느정도 비슷한 궤를 가져가는데 처음 몇개의 레이어에서는 일반적인 MLP를 사용하고 그 뒤는 MoE를 배치하는 등의 작업을 거치게 됩니다. 이 개념이 쓰인 대표적인 모델이 DeepSeek V3이죠.
아니면 마카롱 모델과 일반 MLP를 섞어서 앞뒤 짧은 맥락과 긴 맥락을 한번에 볼 수 있도록 만드는 것 또한 크게 보면 하이브리드 모델이 됩니다.
마치며
이렇게 MLP에 대해서 알아보고 MLP를 활용한 MoE, Macaron, Hybrid 모델까지 알아봤습니다. 사실 MLP가 Attention에 비하면 다룰게 그렇게 많지는 않아서 사실 어떤 내용을 써야할지 고민이 많이 되긴 했습니다.
MLP는 Attention의 짝꿍이라는 개념과 SwiGLU를 빼면 사실 별게 없어서.. 그래서 MLP를 적극 활용한 다양한 모델을 언급해야겠다고 생각을 했죠.
저도 Attention의 지식 깊이와 MLP의 지식 깊이에 차이가 많아서 더 MLP에 대해 쓸게 없었는지도 모르겠습니다. Attention만 놓고보면 사실 나올 수 있는 포스팅이 앞으로도 잔뜩 남아있어서 이후 공부는 MLP를 더 깊이있게 공부해야겠다라는 생각을 하게되는 포스팅이었습니다.
다음 포스팅에서는 조금은 실무 내용이 들어있는 튜닝에 대해서 알아볼까합니다. 요즘은 파인튜닝을 하는 곳은 거의 없다고 할 정도로 많은 분들이 LoRA를 사용하는데요. 다음 포스팅에선 파인튜닝과 LoRA, QLoRA 그리고 한때 붐이었던 DoRA까지 알아보도록 하겠습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요!
'AI Engineering > 이론' 카테고리의 다른 글
| Encoder와 Decoder (Transformer가의 형제들) (0) | 2026.09.25 |
|---|---|
| LLM 모델의 튜닝 방법론 (LoRA, QLoRA, DoRA) (1) | 2026.09.25 |
| 기획자에겐 그림판을, 개발자에겐 메모장을 쥐어줬다 (MHA, MQA, GQA) (0) | 2026.09.24 |
| Attention is All You Need, Transformer의 시작 (0) | 2026.09.24 |
| Attention 레이어 해부하기 (QK회로, OV회로) (0) | 2026.09.24 |