안녕하세요! 이번 포스팅은 조금은 실무적인 내용을 가져왔습니다. 그럼에도 이론이 잔뜩 들어있지만요.
불과 1년전만 하더라도 파인튜닝으로 모델을 튜닝하는게 당연하게 여겨졌다가 어느순간 사라지게 되었습니다. 그 이유가 모델 학습에 필요한 막대한 컴퓨팅 용량과 시간때문이 아닐까 싶은데요.
조금은 비즈니스적인 이유로 많은 사람들이 이제 파인튜닝 대신 LoRA를 많이 사용하는 것 같습니다.
이번 포스팅에선 LoRA와 그 변형인 QLoRA, 그리고 한때 핫했다가 조금은 사그러든 DoRA에 대해서 알아볼까합니다.
그럼 본격적으로 시작해보죠!
파인튜닝
우선 튜닝이 어떤 방식으로 이뤄지는지 알아봐야겠죠?
잠깐 복습하고 넘어가겠습니다!
Attention 연산은 "헤드"라는 단위로 움직이고 이 헤드는 하나의 Attention Layer에 여러개가 존재합니다. Attention Head도 Q헤드, K헤드, V헤드 등 따로따로 부를 수 있는데요.
이걸 가지고 어떻게 튜닝을 이해하면 좋을지 곰곰히 생각해보다가... 머리를 탁 치게되는 설명이 떠올랐으니!
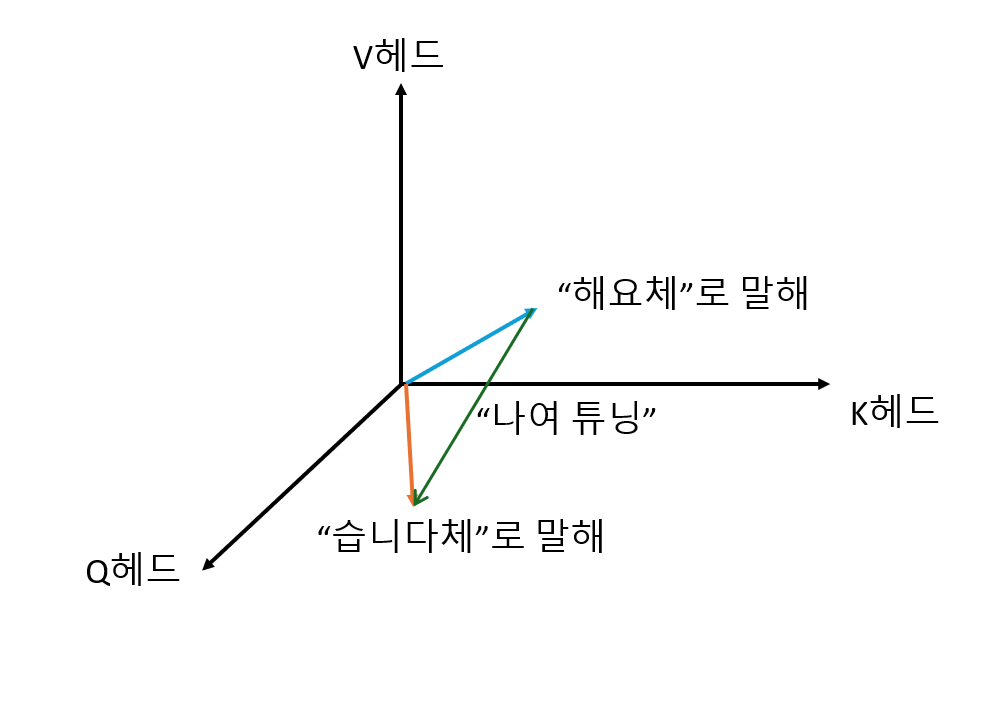
물론 정확한 설명이 아닙니다만...
어떤 모델이 "해요체"로 말하고 있었는데 모델에게 "앞으로 습니다체만 써라"라고 강한 드라이브를 주어서 학습하면 모델이 강제적으로 "습니다체"로 말하게 하는 상황을 만들 수 있습니다.
근데 이게 문제는 모든 부분을 건드리다보니 효과는 확실했지만 컴퓨팅 비용과 시간이 어마어마하게 들어가는 문제가 있었습니다.
LoRA의 탄생
LoRA는 아주 재밌는 발상을 합니다.
"베이스 모델은 냅두고 학습해야되는 부분만 학습시켜서 붙이면 안돼?"
"너 천재냐.."
그 유명한 어댑터 패턴이 등장하게 되는 순간이었습니다. 베이스 모델은 얼려두고 모델 학습에 필요한 델타(차이)만큼을 모델 출력에 붙이는 방법인데 이 방법이 왜 유효했냐면..
기존에도 이런 생각을 안한건 아니었습니다. 다만 각 레이어 뒤에 학습한 내용을 붙이는 과정에서 연산이 배로 늘어나는 문제가 생겼기 때문입니다.
만약 모델의 파라미터 수가 4096개라고 가정해봅시다. 그럼 파인튜닝에서 모든 변화량은 4096 x 4096 = 약 1600만개가 됩니다. 이걸 더 풀어서 생각하면 (모델의 총 파라미터 개수) x (조정할 파라미터 수) 가 됩니다.
여기서 LoRA가 쓴 꼼수가 뭐냐면 "모델을 파인튜닝할 때 4096개를 모두 움직여야할만큼 복잡하지 않을것이다" 라는 가정을 하고 들어갑니다.
그래서 rank라는 개념을 도입, rank는 "학습할 때 얼마나 많은 부분을 중요하게 생각할 것이냐"를 이야기합니다.
지금 4096 x 4096을 했다는건 모든 파라미터가 중요하다고 생각한다는 것이고 rank가 8이라는 것은 8개만 중요하게 보겠다는 것입니다. 즉, rank가 높으면 "얼마나 복잡한 변화를 학습할 것인가"의 척도가 됩니다.
그럼 계산이 이렇게 바뀝니다. 4096 x 8. 어.. 그럼 이게 어쩌라는 것이죠?
그리고 여기서 한가지 꼼수가 더 들어갑니다. 행렬의 마법을 이용한 것이죠. 수학 얘기하면 뒤로가기 누르실게 뻔하니까 가볍게 설명하자면
(4096 x 8) x (8 x 4096) = 4096 x 4096
앞에 있는 친구가 A라고 하고 뒤에 있는 친구를 B라고 하면 A의 의미는 "8차원으로 줄인다" 그리고 B의 의미는 "8차원을 다시 4096차원으로 늘린다"가 됩니다.
중간 다리를 하나 두는 것이죠.
그리고 이 과정에서 생긴 가중치 W = dBA (델타 BA)가 되는 것이고 이 부분만 나중에 모델이 출력할 때 행렬합으로 계산하겠다는 의미입니다.
LoRA의 마법과 반작용
LoRA를 도입하니 마법이 일어났습니다.
- 모델 파라미터를 전부 변경하지 않아도 되니 학습 메모리가 크게 줄어들었습니다.
- 학습 속도와 비용이 줄어들었습니다.
- 원본 모델을 보존하고 어댑터만 갈아끼우는 것이 가능해졌습니다. 언제는 "해요체"로 언제는 "습니다체"로 말할 수 있게 되었다는 뜻이죠.
- 모델은 냅두고 수MB의 가중치만 업데이트하면 됩니다.
이렇게 모두가 행복해질 수 있을것 같았지만 LoRA에도 큰 문제가 있었습니다.
모델을 학습할 때 올려두어야한다는 제약은 사라지지 않았습니다. 만약 31B 모델을 그냥 서빙용으로 올릴 때는 FP16기준 62GB의 VRAM이 필요했지만 학습을 위해서는 300GB의 VRAM이 필요해집니다.
또한, 파인튜닝에 비해 성능이 나오지 않는 문제도 생겼습니다. 당연한 얘기겠지만 특정 부분만 학습한 것이 모든 부분을 학습한 것과는 차이가 있기 마련이죠.
벼락치기로 시험범위만 공부한 친구와 교과서의 모든 내용을 암기한 친구의 성적차는 날 수 밖에 없는 것이 현실이죠.
그래서 LoRA는 파인튜닝을 영원히 뛰어넘지 못하는 몸이 되었습니다. 그럼에도 학습 메모리와 비용이 크게 줄어들었다는건 장점이었지만 그로인해 포기해야하는 것도 생기기 마련이었습니다.
QLoRA의 탄생
LoRA의 문제는 모델을 학습할 때 여전히 VRAM에 올려야한다는 것이었는데 QLoRA는 여기서 Q 즉, Quantization이 들어갑니다. 모델을 4비트로 양자화 한 뒤 LoRA를 진행하는 것이죠.
일반적으로 4비트 양자화를 하게되면 모델의 크기는 1/4로 줄어듭니다. 기존에 31B가 300GB VRAM이 필요했던 것이 단박에 75GB로 줄어드는 마법이 생겼죠.
그럼에도.. 4비트 양자화는 아직까지 여전히 손실률이 크기 때문에 모델의 성능이 더욱 들쭉날쭉 해지는 문제가 생기게 되었습니다.
안그래도 rank를 이용해서 특정 부분만 학습을 하는데 여기다 4비트 양자화로 모델 성능이 손실되니 쉽지않았죠.
물론 QLoRA도 학습할 때 4비트로 양자화하고 다시 원래 베이스 모델로 돌아오긴 합니다. 하지만 4비트로 양자화 하고 LoRA의 가중치를 뽑아낸 뒤 다시 베이스 모델로 돌아올 때 이 LoRA 가중치가 베이스 모델에 적합할까는 여전히 의문인 것이었죠.
"기술에 은탄환은 없다"
저는 이 말을 굉장히 좋아하는데요. 어떤게 해결이 되면 또 다른 부분이 문제가 생긴다는 것이죠. 기존 VM에서 Docker가 나왔을 때 세상을 구할것 같았지만 컨테이너가 100개만 되도 관리가 어려워지자 k8s가 나왔고 이제 해결됐다고 외쳤을 땐 이미 관리해야되는 관리포인트가 100개정도 늘어난 뒤였습니다.
QLoRA도 학습 장벽을 무너뜨리진 못했습니다. 그리고 DoRA가 등장하죠.
DoRA의 탄생
LoRA에서 부족한 부분이 바로 성능이었습니다. 교과서를 모두 외운 미친놈을 시험 성적으로 이길 수는 없었으니까요.
QLoRA로 학습 비용을 더 줄이려 했지만 그건 쉽지 않았고 연구자들은 다른쪽으로 생각이 뻗어나갑니다.
"LoRA를 더 깎아보자"
기존 LoRA의 한계로 많이 짚었던 것이 바로 "rank"의 도입을 많이들 말하곤 했습니다. 특정 파라미터만 학습하는게 성능을 낮추는 원인이라고 이야기 했었죠.
DoRA의 논문 저자는 이런 질문을 던집니다.
"진짜 파라미터 수가 성능 문제를 일으킨게 맞아? 학습 방법의 문제는 아니고?"
LoRA의 문제는 파라미터 수를 제한한다는 것도 있었지만 벡터의 크기와 방향 모두가 바뀐다는 문제가 있었습니다. 이건 마치 핸들을 꺾으면 브레이크 or 엑셀이 동시에 눌리는 것과 같습니다.
이런 자동차는 운전하기 쉽지않겠죠.
그래서 DoRA는 이런 방법론을 도입해봅니다.
"방향은 LoRA로 바꾸고 크기는 직접 학습해보자"
그리고 실제로 DoRA는 의미있는 숫자를 보여줬습니다. 원 논문에서 저자가 언급한 LoRA의 문제는 파라미터 수가 아니었습니다. 바로 학습하면서 생기는 "기울기의 변화"였죠.
원래는 마이너스를 가리키던 파인튜닝이 LoRA를 적용하자 기울기가 플러스로 돌아서면서 성능에 문제가 생긴거 아니냐는 것이었죠. 그래서 연구자들은 DoRA를 도입하자 기울기가 마이너스로 안정적으로 돌아선 것을 확인했습니다.
그리고 이건 DoRA가 성공한 것처럼 보이는 효과를 주었습니다.
그리고 이는 LoRA처럼 학습 비용을 줄이고 파인튜닝처럼 성능을 둘 다 챙기는 절충안이 되었습니다.
그럼에도 DoRA의 한계는 있었다
LoRA는 들어보셨어도 DoRA는 처음 들어본 분들이 다수일겁니다. 이게 업계 표준이 되지는 못했기 때문입니다.
물론 DoRA가 LoRA의 학습비용, 파인튜닝의 성능을 모두 챙기긴 했습니다. 대신 이건 그렇기에 k8s 꼴이 나버렸죠.
"신경쓸게 너무많아.."
LoRA는 아주아주 단순했고 구현하기도 굉장히 편했습니다. "델타BA만 신경쓰자" 이게 LoRA의 기본 골자였으니까요. 다만 DoRA는 델타BA에 스칼라(크기)값까지 고려해야되서 학습/추론 과정이 너무 복잡해진게 문제였습니다.
Hugging Face에서의 공식문서에서도 DoRA는 순수 LoRA보다 학습 오버헤드가 크다고 명시하고 있고 LoRA에 비해 속도와 메모리 부담이 커질 수 있다는 것을 명시했습니다.
또한, LoRA에서 rank가 8정도로 낮았을 때는 DoRA의 성능이 LoRA를 상회하는 모습을 보였지만 LoRA도 rank가 32나 64정도 되는 순간 차이가 상대적으로 많이 줄어들었죠.
그 결과 실무자들은 이런 고민에 빠지게 됩니다.
"단순하고 개발 생태계가 성숙하고 충분한 성능이 보장되는 LoRA"
vs
"조금 더 높은 성능, 그리고 복잡한 계산과 구현인 DoRA"
제가 실무자 입장에서 볼때 DoRA는 계륵으로 보이긴 했습니다. 소잡는 칼로 닭잡는 꼴, 즉 오버엔지니어링이 실무 상황에선 굉장히 리스키하고 피해야되는 상황 중 하나인데 DoRA가 딱 그렇게 보였거든요.
마치며
이렇게 파인튜닝과 LoRA, QLoRA, DoRA까지 알아봤습니다. 조금은 실무 얘기를 해서 조금은 가벼운 마음으로 편하게 포스팅을 쓸 수 있었던 것 같습니다.
이론과 관련된 포스팅을 쓸 땐 어떻게 직관적이고 쉽게 설명할 수 있을지 이리저리 생각해보곤 하는데 이번 포스팅은 머리속에서 설계가 잘 떠올라서 잘 마무리지을 수 있었습니다.
실무에서도 LoRA를 고려하게 되는데 보통 한정된 자원이기 때문에 QLoRA를 고려하게 됩니다만, 요즘 핫한 Ontology(온톨로지)나 RAG, 그중에서도 GraphRAG를 적절히 사용하면 굳이 튜닝이 필요한가..싶은 생각도 들기도 합니다.
보통 알고리즘을 고치기 보다는 구조를 통해 개선하는걸 좋아하는 저로서는 LoRA는 아직 필요성을 못느끼긴 했습니다.
다만 LoRA의 탄생과 QLoRA, DoRA로 이어지는 연구 흐름은 꽤나 큰 울림을 주는 주제라고 생각해서 포스팅 주제로 가져와봤습니다.
다음 포스팅은 Encoder와 Decoder에 대해서 포스팅을 할까합니다. 이것도 굉장히 재밌는 주제니까 많은 관심 부탁드립니다.
긴 글 읽어주셔서 감사합니다! 오늘도 즐거운 하루 되세요!
'AI Engineering > 이론' 카테고리의 다른 글
| Encoder와 Decoder (Transformer가의 형제들) (0) | 2026.09.25 |
|---|---|
| MLP레이어란? (MoE와 Hybrid 모델, Macaron 모델) (0) | 2026.09.25 |
| 기획자에겐 그림판을, 개발자에겐 메모장을 쥐어줬다 (MHA, MQA, GQA) (0) | 2026.09.24 |
| Attention is All You Need, Transformer의 시작 (0) | 2026.09.24 |
| Attention 레이어 해부하기 (QK회로, OV회로) (0) | 2026.09.24 |