안녕하세요! 이번 포스팅에선 기계론적 해석학의 발전에 크게 이바지한 SAE (Sparse Auto Encoder)에 대해서 알아보도록 하겠습니다. 수학 공식이 조금 등장해서 포스팅으로 쓰기 조금 부담스럽긴 하지만 기계론적 해석학 카테고리에 SAE가 빠지는건 아무래도 아닌 것 같아서 적어보도록 하겠습니다.
이전 포스팅인 "LLM은 확률론적 앵무새가 아닐 수도 있다" 포스팅에서도 SAE가 잠깐 소개 되었었죠?
https://coding-review.tistory.com/634
LLM은 확률론적 앵무새가 아닐지도 모른다
안녕하세요! 이번 포스팅은 제가 개인적으로 관심있는 분야인 기계론적 해석학의 현재 상황을 정리하고 한참 후에 제가 "아 이때는 이정도 블랙박스가 해소되었구나"를 기억하기 위해 작성해보
coding-review.tistory.com
자세한 포스팅은 위의 링크를 참고해주세요!
잠깐 위의 포스팅의 SAE 부분을 복습하자면, SAE는 LLM의 블랙박스를 뜯어내기위한 훌륭한 현미경이라고 소개드렸습니다. 뉴런에는 feature를 여러개 담아둘 수 밖에 없는 구조를 가지고 있고 그래서 어떤 feature가 반응했는지 파악하기 어려워 뉴런에 있는 feature를 분해한 것입니다.
이번 포스팅에선 SAE가 어떤 원리로 feature를 그렇게 분해할 수 있는건지 정리해봤습니다! 바로 시작해보겠습니다
SAE란?
SAE는 Sparse Auto Encoder의 약자로 한국어로 번역하면 '희소 자동 인코더'인데 이 말은 곧 뭉쳐있는 하나의 뉴런을 더 작은 feature로 인코딩하겠다는 말입니다.
Encoder는 이전 포스팅에서도 잠시 언급드렸지만 맥락을 파악하는 요소입니다. 아래 포스팅에 그 내용이 자세하게 나와있으니 참고해주시면 감사하겠습니다!
https://coding-review.tistory.com/630
Encoder와 Decoder (Transformer가의 형제들)
안녕하세요! 이번 포스팅은 이전 포스팅에서 예고한대로 Encoder와 Decoder에 대해서 포스팅을 진행해볼까합니다. 이번 포스팅은 이전 포스팅에서의 Attention에 대한 이해가 기본이해가 선행되면 더
coding-review.tistory.com
위의 포스팅에선 Encoder Only, Decoder Only, Encoder-Decoder 다양하게 조합된 모델들을 살펴봤고 우리가 잘 아는 LLM은 Decoder Only에 속한다고 말씀드렸습니다.
Encoder는 맥락을 파악하는데 초점이 맞춰져있고 Decoder는 토큰을 생성하는데 초점이 맞춰져있습니다. 그래서 다시 말하면 SAE는 "아주 작은 feature의 맥락을 볼 수 있는 Encoder"라는 뜻이 됩니다.
SAE의 기본 개념
SAE는 아래와 같은 흐름을 가지고 있습니다.
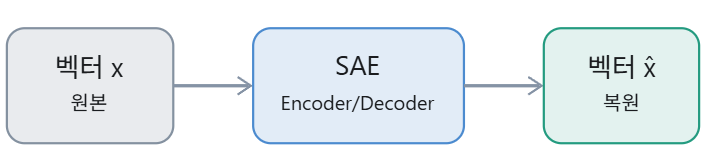
우선 여기서 들법한 질문부터 해결하고 넘어가겠습니다.
1. 벡터 x란 무엇인가?
벡터 x란 벡터로 되어있는 모든 것을 의미합니다. 즉, 잔차 스트림이 될 수도 있고, Q, K, V 그 어느것이 될 수도 있는 것이죠.
2. 벡터 x를 왜 복원하는가?
복원하는 이유는 우리가 SAE로 얻고싶은 것이 x이기 때문입니다. x가 어떻게 동작하는지 확대해보고싶은 대상이기 때문에 SAE라는 현미경으로 확인한 x의 형태를 모방해야 x가 어떻게 작동하는지 알 수 있기 때문이죠.
예를 들어서 잔차 스트림을 SAE를 통해서 확인하고싶다고 가정해보겠습니다. 잔차 스트림을 SAE로 확대했을 때 얻을 수 있는 것은 Attention Layer를 통과한 스트림에 무엇이 더해지는가와 MLP Layer를 통과한 스트림에 무엇이 더해지는가입니다.
그럼 x의 복원본인 x햇은 x를 복원했기에 우리는 x햇을 보면 원본인 x를 유추할 수 있게 되는겁니다.
SAE의 Encoder/Decoder는 각 feature를 분해하고 확장해서 특정 feature에 불을 키고 이를 사람이 복원된 x햇을 통해 확인하는 것이죠.
SAE의 동작원리: 기본편
SAE는 기존 벡터의 차원을 억지로 높여서 하나의 뉴런에 들어있던 여러개의 feature를 전부 분해합니다. 예를 들어서 어떤 뉴런에 강아지에 대한 정보와 이산수학에 대한 정보가 같이 들어있다고 가정해보죠.
이 둘은 사실상 같은 문장에서 등장할 확률이 거의 0에 수렴하기 때문에 모델은 학습하면서 이 둘을 같은 뉴런에 넣어놓습니다.
그 상황에서 SAE는 이 하나의 뉴런에 들어있던 feature를 찢어버립니다. 편의상 A를 강아지, B를 이산수학이라고 가정하겠습니다.
만약 사람이 "진돗개는 어느나라의 토종견이야?"라는 질문이 들어오면 A만 반응하고 B는 꺼지게 되는 것을 볼 수 있는 것이죠. 기존에는 이 둘이 하나의 뉴런에 들어있어 강아지에 대한 질문과 이산수학에 대한 질문 두개 다 반응했는데 SAE를 통과한 이 질문은 이제 강아지에 해당하는 A만 반응하는걸 확인할 수 있습니다.
기존에 벡터가 4096차원이었다면 이 벡터를 16384차원으로 확장하는 것이 바로 SAE의 본질입니다.
하지만 그렇다고 사람이 보기 편한 형태로 확인할 수 있는건 아닙니다. 사람의 눈엔 이렇게 보이거든요
0 0 0 0 0 0 1 0 0 0 0 0
0 0 0 0 1 0 0 0 1 0 0 0
0 0 0 1 0 0 0 0 1 0 0 0
0 1 0 0 0 0 0 0 0 0 0 1
그럼 사람은 이렇게 판단하는거죠. "강아지에 대한 질문을 넣었더니 6번 인덱스가 지속적으로 반응을 한다. 그럼 6번 인덱스가 강아지와 관련된 feature일 것이다"
하지만 이건 그럴수도, 아닐수도 있습니다. 직접 feature를 조정하면서 찾아내는 수밖에 없죠.
이제 수학공식이 나올 예정입니다. 이 부분은 더 자세한 동작원리에 대한 내용이라 넘어가셔도 무방합니다!
SAE의 동작원리: 심화편
SAE가 내부적으로 어떻게 동작하길래 관련없는건 다 죽이고 관련있는 것만 살려놓을까?
초기 SAE는 ReLU라는 활성화 함수를 사용했습니다. 활성화 함수에 대한 자세한 내용은 아래의 포스팅에서 참고해주시면 감사하겠습니다!
https://coding-review.tistory.com/632
MLP의 활성화 함수란? SwiGLU와 역전파의 상관관계
이전 포스팅에서 모델은 수십개의 Layer로 나눠져있고 각 레이어는 다시 Attention Layer, MLP Layer로 나눠져있고 Attention Layer는 QK회로, OV회로로 나눠져있다고 언급했습니다. 그러면서 MHA, MQA, GQA로 이
coding-review.tistory.com
ReLU는 x<0인 부분에선 0으로, x>0인 부분에선 1로 표현한다고 위의 포스팅에서 언급되었습니다.
즉, 연구원들은 특정 포인트에서 feature가 반응하도록 조절할 수 있다는 것이죠.
위의 포스팅에서 활성화 함수와 역전파와의 상관관계를 언급하면서 이 활성화 함수로 인해 모델이 학습할 때 어떤 부분이 손실함수의 기울기를 급격하게 바꿀 수 있을지 파악하고 그 부분의 손실을 줄이기 위해서 값을 미세조정한다고도 말씀드렸습니다.
1. 우선 벡터의 차원을 확장하자
벡터의 차원을 확장하려면 어떻게 해야될까요? 행렬에서는 차원을 높이기 위해서 "아핀 변환"이라는 약을 칩니다.
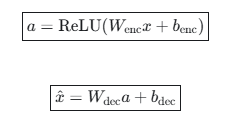
이게 SAE의 수식인데 x가 원본 벡터이고 x햇이 복원된 벡터입니다.
우리가 주목해야되는 부분은 ax + b의 구조입니다. 이걸 행렬에선 아핀 변환이라고 부르고 우리가 지금 보려고 했던 벡터의 차원 확장은 ax < 이 부분에서 진행됩니다.
행렬의 곱셈을 보면 가운데 두개가 같으면 그 두개를 삭제시키는 규칙이 있습니다. 즉, (1, 3) x (3, 2) 앞은 행 뒤는 열입니다. 1행 3열짜리 행렬과 3행 2열짜리 행렬 두개를 곱하면 (1, 2) 즉, 1행 2열짜리 행렬로 바뀝니다.
1행 3열 = 3차원 => 1행 2열 = 2차원
지금 차원이 하나가 줄었습니다?
이렇게 두개를 곱할 때 가운데 두개가 같으면 차원을 확장할 수도, 축소할 수도 있는 것이죠.
사람이 마음만 먹으면 벡터를 확장할 수 있다는 의미가 됩니다.
2. 확장된 벡터에 스위치를 켜주자
ReLU는 앞선 포스팅에서도 말씀드렸지만 x<0 인 부분은 다 꺼버리는 특징이 있습니다. x<0인 부분이 다 0으로 되면 이 부분의 기울기가 0이 될 것이고, 기울기가 0이라는 말은 손실 함수의 변화율이 0이라는 의미이고, 모델은 이렇게 판단합니다.
"아 이 값은 의미 없는 값이야"
원래 기존의 벡터 x가 아핀 변환으로 차원이 높아지고 ReLU에 들어가면 의도적으로 값이 지워집니다. 즉, 정보의 손실이 있죠.
3. 다시 원래대로 복원하자
정보의 손실이 있으면 의미가 없습니다. 우리가 원하는건 정보의 손실이 없는 차원의 확장인데 차원만 확장되고 feature가 날아가서 정보의 손실이 있는건 원하지않죠.
그래서 Decoder의 가중치(W)와 편향(b)인 bias를 다시 입력해서 최대한 원래의 벡터인 x와 근접하게 만듭니다.
여기서 Decoder가 x와 근접하게 복원은 하지만 실제 원본 x는 아니기 때문에 이것도 근사값이긴 합니다만, 최대한 복원한 x햇이 기존 x를 추적하기에는 안성맞춤이죠.
SAE의 한계
SAE의 한계는 너무나 당연하게도 feature를 사람이 읽을 수가 없다는 것입니다. 수많은 feature 중에 반짝이는 것, 그리고 그 중에서도 우리가 원하는 feature라는 것은 수많은 실험 끝에 얻을 수 있는 결과입니다.
또한, SAE는 모델이 내부적으로 어떤 feature를 사용하는지는 알지만 이게 어떻게 출력으로 이어지는지는 알 수 없다는 한계도 가지고 있습니다.
저는 SAE를 현미경에 빗대곤 하는데 현미경으로는 우리가 모르던 부분을 확대해서 보여주긴 하지만 정확한 인과를 모른다는 한계와 같기 때문인데요.
그럼에도 결국 SAE
하지만.. 이렇게 사용한다면 어떨까요?
Attention Layer > 잔차 스트림 > MLP Layer > 잔차 스트림
이 흐름에서 이 두개의 잔차 스트림을 SAE로 들여다보면 어떻게 될까요? 즉, 입력값 x를 넣었을 때 출력값 y가 나온 것을 입력값 x에 예측값 y햇으로 볼 수 있다면?
어떤 입력을 넣었을 때 MLP에서 어떤 feature를 건드렸는지 확인할 수 있게 됩니다. 이것이 다음 기계론적 해석학 포스팅 주제인 Transcoder입니다.
MLP는 SwiGLU가 있었죠? 어떤 값을 통과시킬지, 어떤 값을 증폭시킬지 결정하는 gate가 있고 그걸 선택하는 switch가 있었습니다. MLP 앞뒤에 있는 잔차 스트림을 분석하면 MLP가 어떤 패턴으로 잔차 연결을 진행하는지를 추적할 수 있죠.
어? 하지만 MLP가 한두개 있는게 아닌데요?
맞습니다. MLP는 Transformer Layer의 각 층마다 존재하죠. 앞의 MLP가 뒤의 MLP에도 영향을 미칩니다. 그래서 이 Transcoder는 하나로는 부족하고 Transcoder를 이어붙인 CLT라는 개념이 등장하는 것입니다. Cross Layer Transcoder의 약자이죠.
마치며
이번 포스팅에선 기계론적 해석학의 큰 도약이라고 할 수 있는 SAE의 발견과 동작원리를 기본, 심화로 나눠 알아봤습니다. SAE의 동작을 추상화하면 굉장히 간단한데요.
1. feature를 확장한다
2. 관련없는건 없앤다
3. 다시 원래 값으로 복원한다.
이번 포스팅을 읽으시고 SAE의 동작원리를 수학적으로 이해하실 필요는 없을 것 같습니다. 다만, 위의 세가지 단계로 SAE가 동작한다는 사실만 챙겨가시면 SAE에서 가져갈 수 있는건 다 가져간거라고 생각합니다.
다음 포스팅은 "드디어 LLM이 무슨 생각을 하는지 보이기 시작했다"라는 내용의 포스팅으로 찾아뵙도록 하겠습니다.
긴 글 읽어주셔서 감사합니다. 오늘도 즐거운 하루 되세요!
'AI Engineering > 기계론적 해석학' 카테고리의 다른 글
| LLM은 확률론적 앵무새가 아닐지도 모른다 (0) | 2026.10.11 |
|---|---|
| 특명: 학습하지 않은 패턴을 학습해라 (Few Shot의 동작 방식) (0) | 2026.02.25 |
| LLM한테 페르소나를 적용하면 어떻게 이를 수행하는걸까? (0) | 2026.01.24 |